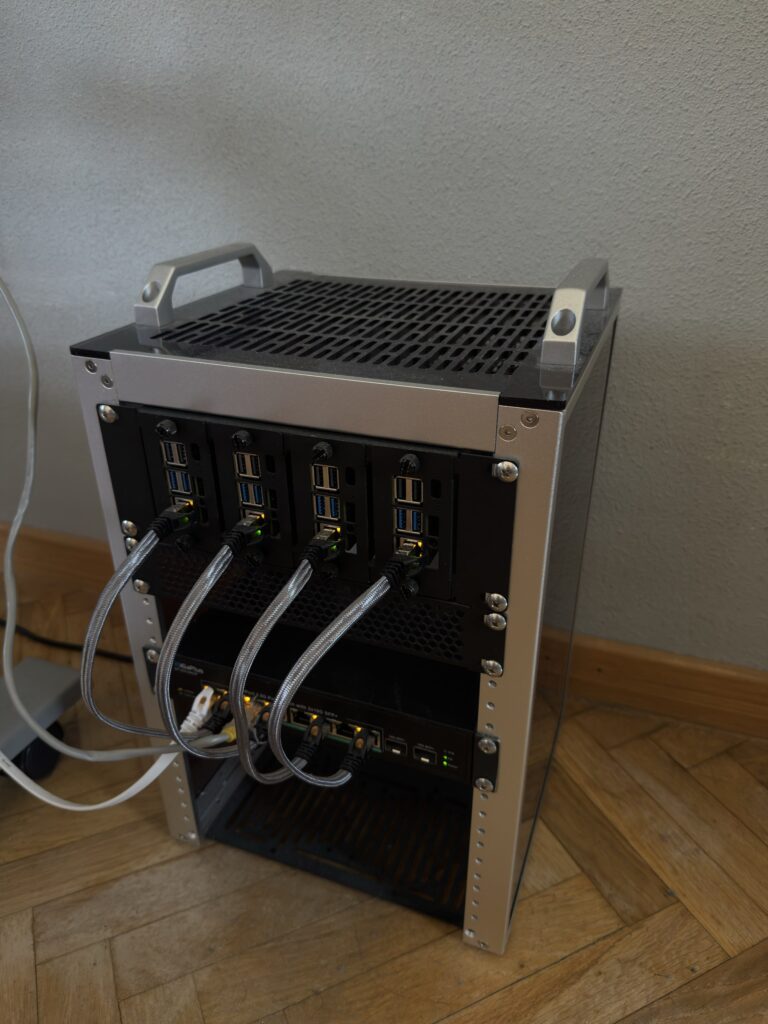
Me llegó por la página de contacto del blog un repositorio de GitHub relacionado con mis artículos sobre Potato OS. Describe un clúster Raspberry Pi LLM formado por cuatro Raspberry Pi 5 de 16 GB que ejecuta Qwen3-30B-A3B, un modelo MoE de 30.000 millones de parámetros. El proyecto declara 15,1 tokens por segundo al generar texto. La duda es cómo se llega a esa cifra cuando las placas hablan entre sí por un cable Gigabit Ethernet.
La respuesta corta es que la red se lleva entre una cuarta parte y un tercio del tiempo de cada token. El resto de la mejora sale de repartir la memoria entre cuatro placas, de usar un modelo MoE y de muchos ajustes pequeños. Además, las cifras tienen matices que explico más abajo.
Qué aporta distributed-llama y qué añade el fork
distributed-llama es un proyecto de código abierto con licencia MIT de Bartłomiej Tadych (b4rtaz). El repositorio que me llegó es un fork de Hellomatik. La base original ya incluye lo importante: paralelismo de tensores, sincronización entre nodos por Ethernet y un nodo raíz que carga el modelo y reparte los pesos. También trae un servidor API propio y funciona en Linux, macOS y Windows, con optimizaciones para ARM y para CPU x86_64 con AVX2.
El original tiene sus límites. Solo admite 1, 2, 4 nodos y así sucesivamente, es decir, potencias de dos, y el máximo de nodos coincide con el número de cabezas KV del modelo. Además solo acepta dos combinaciones de cuantización: modelo Q40 con datos de sincronización en Q80, o F32 en ambos. Según el registro de la discusión #255, Qwen3-30B-A3B tiene 4 cabezas KV. Por tanto, cuatro nodos serían el máximo para este modelo, una deducción mía a partir de ambos documentos.
El fork de Hellomatik parte de la versión 0.16.5 y añade parches en el código, servicios de systemd, ajustes de kernel y de la tarjeta de red, un proxy en Python y un informe técnico con DOI en Zenodo. La firma del informe es Daniel Correa Villa. El reparto del trabajo sigue siendo el del original.
El hardware y el modelo del clúster
Cada nodo es una Raspberry Pi 5 de 16 GB con SSD NVMe, procesador BCM2712 con cuatro núcleos Cortex-A76 a 2,4 GHz sin overclock y memoria LPDDR4X de unos 17 GB/s. Usan Debian 13 con kernel 6.12.75. Ninguna placa emplea GPU ni NPU para calcular.
El modelo pesa 17 GB según la lista del proyecto original y está en formato Q40, una cuantización de 4 bits. Ese fichero no cabe en una Raspberry Pi 5 de 16 GB, ni siquiera sin contar el sistema. Repartido entre cuatro placas, cada una guarda unos 4,3 GB de pesos, según mi cuenta. Así que el clúster resuelve ante todo un problema de capacidad, y la velocidad viene después.
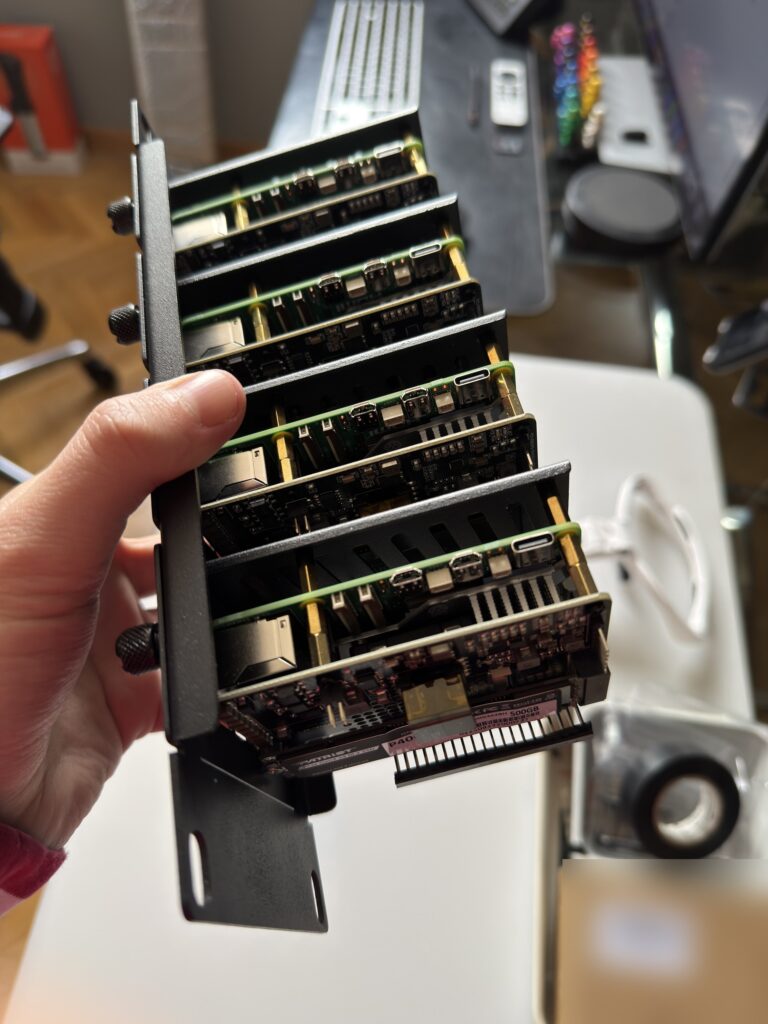
Un clúster Raspberry Pi LLM reparte cada capa entre las cuatro placas
Con paralelismo de tensores, cada capa del modelo se divide en cuatro trozos y cada Raspberry Pi calcula el suyo. El nodo raíz también calcula su parte, y los otros tres solo calculan. Los cálculos usan las instrucciones NEON de producto escalar del Cortex-A76. Al terminar cada capa, los nodos se intercambian los resultados parciales mediante un all-reduce sobre TCP.
Qwen3-30B-A3B tiene 48 capas, así que esa sincronización se repite muchas veces por token. Según el README del fork, la raíz consume unos 12 GB de RAM y cada trabajador unos 6,3 GB. El original avisa de que la raíz necesita algo más de RAM que los trabajadores.
Cuánto pesa la red en cada token
El autor del proyecto original publicó en la discusión #255 el registro de una prueba con cuatro Raspberry Pi 5 de 8 GB y este mismo modelo. Es la referencia pública: 13,04 tok/s al generar y 14,33 tok/s al procesar el prompt. En el registro, cada token tarda entre 49 y 70 ms en calcularse. La sincronización suma casi siempre entre 14 y 37 ms, con algún pico de 94 ms.
Por cada token, el nodo raíz envía 636 kB y recibe 1.057 kB. Un enlace Gigabit mueve unos 125 MB/s en teoría, así que recibir esos 1.057 kB lleva unos 8,5 ms. Es una cuenta mía a partir del registro. Esa transmisión explica buena parte de la sincronización, y el resto es latencia y espera al nodo más lento. Según el README del fork, la latencia entre nodos es de 0,226 ms.
El comando de esa prueba usa --buffer-float-type q80, el parámetro que fija la precisión de los datos que viajan entre nodos. En la práctica, cada valor se envía con unos 8 bits en lugar de 32, lo que reduce el tráfico.
La memoria marca el techo de velocidad
La generación de texto depende del ancho de banda de memoria, porque para cada token hay que leer de la RAM los pesos que participan. El README del fork mide con contadores del procesador que el 49,25 % de los ciclos se pierde esperando a memoria. Cada nodo lee y escribe unos 11,4 GB/s, cerca del 85 % del máximo de una prueba Triad con cuatro hilos.
Hay dos factores que ayudan. Primero, con paralelismo de tensores cada placa lee solo su cuarta parte de los pesos, así que el ancho de banda conjunto se multiplica por cuatro. Segundo, un modelo MoE activa únicamente 8 de sus 128 expertos por token. Según el README del fork, el peso leído por token bajó de unos 5 GB con Llama 3.1 8B denso a unos 3 GB con Qwen3-30B-A3B, aunque el total de parámetros pasó de 8.000 a 30.000 millones.
Ese cambio de modelo fue la mejora más grande del proyecto: de 7,01 a 11,40 tok/s, un 63 % más. Con esos datos, cada nodo lee unos 0,75 GB por token (3 GB entre cuatro), que a 17 GB/s son unos 44 ms. Coincide con los 49 a 70 ms de cálculo del registro. En ese tiempo la red mueve unos 1,7 MB, unas 400 veces menos que la memoria. Son órdenes de magnitud, porque la cuenta mezcla datos de dos fuentes.
Los ajustes de red y de sistema, uno a uno
Como no pueden reducir los bytes, los ajustes de red recortan latencia en cada sincronización. La mayor ganancia de red viene de SO_BUSY_POLL: el kernel espera activamente hasta 50 microsegundos en recv() en lugar de dormir el hilo, y se ahorra el coste de despertarlo. El resto abre buffers TCP de 8 MB, activa TCP_NODELAY y desactiva GRO, que según el README añade entre 50 y 200 µs de espera a propósito. También amplía el anillo de recepción de la tarjeta de red.
La tabla resume lo que documenta el proyecto. Los porcentajes salen de las medias del README y no se encadenan exactamente, porque el proyecto vuelve a medir la base en varios puntos.
| Cambio | Resultado según el README |
|---|---|
| Modelo MoE en lugar de denso | 7,01 a 11,40 tok/s (+63 %) |
| Contexto de 32K en lugar de 64K, sin usar swap | 11,40 a 12,71 tok/s (+11 %) |
| SO_BUSY_POLL y SO_PRIORITY | 12,71 a 13,34 tok/s (+5 %) |
| Flags de compilación con dotprod | 13,34 a 13,82 tok/s (+4 %) |
| GRO desactivado, buffers TCP y swappiness | 13,72 a 14,01 tok/s (+2,1 %) |
| Sin prefetch por software en la multiplicación de matrices | 13,85 a 14,00 tok/s (+1,05 %) |
| Bloques de 16 KB en send y recv | 14,27 a 14,45 tok/s (+1,3 %) |
| Anillo RX, RFS y NAPI diferido | 14,17 a 14,45 tok/s (+2,0 %) |
También documentan lo que falló. MSG_ZEROCOPY y TCP_QUICKACK restaron un 0,9 % cada uno, el NAPI en hilo dedicado un 3,9 % y la optimización guiada por perfil hizo que el clúster fallara en la primera petición. El README cita además que llama.cpp con RPC quedó 25 veces por debajo de un solo nodo, según Jeff Geerling. Sobre el artículo HALO, que solapa cálculo y red, dice que solo logra 1,12 veces más en una LAN limpia.
Qué parte de la mejora es real
Hellomatik presenta 15,143 tok/s al generar como un 16,1 % más que el 13,04 del autor original. Sin embargo, en un comentario de esa misma discusión indican que la versión sin modificar da 13,15 tok/s en sus placas de 16 GB. Sus parches de código suben esa cifra a 13,88 tok/s, un 5,6 % más, y la configuración del sistema completa el resto hasta 15,143.
Es decir, sobre el mismo hardware la ganancia real ronda el 15 %, y la mayor parte viene de ajustes de sistema. Además, el README atribuye un 5,18 % a parar los agentes de monitorización Grafana Alloy y cAdvisor durante la prueba. Esa parte es una condición de medida, porque quien monitorice su clúster no la tendrá. Como punto a favor, el proyecto valida cada optimización con un SHA-256 de 100 tokens a temperatura cero y, según su README, ninguna cambia el resultado del modelo.
El README mezcla además cifras de fechas distintas. El titular del repositorio dice 14,4 tok/s, que es el rendimiento sostenido con el prompt incluido, mientras que 15,143 es solo generación. Algunas secciones aún citan 14,046 tok/s y hablan de doce parches donde la tabla lista nueve. Tampoco hay, que yo sepa, ninguna réplica independiente de estos resultados.
Qué significa esto para Potato OS
En mis artículos sobre Potato OS y sobre Gemma 4 12B en Raspberry Pi 5 el límite práctico es la RAM de una sola placa. El README de Potato OS da para una Pi 5 de 8 GB con SSD unos 8 a 9 tok/s con Qwen3-30B-A3B en Q3_K_S, un fichero de unos 10 GB que se lee en parte desde el SSD. El clúster llega a 15,1 tok/s con Q40 y todo en RAM.
Son entre 1,7 y 1,9 veces más, aunque la comparación no es exacta. Cambian la cuantización, el motor (ik_llama.cpp frente a distributed-llama) y la memoria disponible. El precio también cambia: cuatro placas de 16 GB, cuatro fuentes, un switch y un despliegue con systemd en cada nodo.
Llevo tiempo escribiendo sobre modelos que caben en una sola Pi 5 con Potato OS. Este proyecto demuestra que repartir un MoE de 30.000 millones de parámetros entre cuatro placas funciona, y que la red pesa menos de lo que cabría esperar porque solo viajan activaciones. La mejora real sobre el código original ronda el 15 % y buena parte sale de ajustes de sistema. Para estudiar computación distribuida, el trabajo de Bartłomiej Tadych y de Hellomatik es una guía muy completa de qué probar y qué descartar.